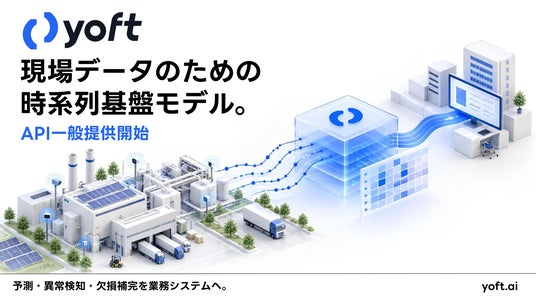
株式会社ニューロジカ(本社:東京都渋谷区、代表取締役:ピーク エイダン ゼファー)は、現場データを扱う時系列基盤モデル「yoft」を開発し、サービスサイト「yoft.ai」でAPIの一般提供を開始しました。
yoftは、電力需要や売上、設備のセンサー値など、多様な現場データを扱うための基盤モデルです。不規則な観測間隔や欠測、高頻度の信号に対応し、将来予測・異常検知・欠損補完を一つの基盤で行います。
不規則な観測間隔や欠測に対応する時系列基盤モデルで、予測・異常検知・欠損補完をAPIとして一般提供するのは、当社が調査した公開情報の範囲では、日本企業で初めてです※1。
用途ごとにモデルを一から開発する負担を減らし、予測を日々の業務に組み込むためのAPIを提供します。
導入・開発のご相談:https://yoft.ai/ja#contact
※1 2026年10月14日時点、当社による国内企業の公開情報調査。上記の入力対応・3機能・自社開発・ホスト型APIの一般提供をすべて満たすものを比較対象としています。
■ 市場背景:予測の活用を阻む、モデル開発・運用の負担
電力の需給調整、商品の発注、設備の保全、物流の配車。企業の日々の判断の多くは、「この先、数値がどう動くか」を前提にしています。IoTセンサーや業務システムの普及でデータの蓄積は進んでいますが、それを予測に生かすには、モデルの開発と継続的な運用が必要です。これまでの予測ソリューションでは、商品や設備、拠点ごとに個別のモデルを設計し、学習と調整を繰り返す必要がありました。対象が増えるほど専門人材と時間がかかり、予測を使いたい業務があっても、開発や運用の負担が導入の壁になっていました。この負担を減らす技術として、「時系列基盤モデル」が注目されています。
時系列基盤モデルとは
エネルギー、交通、金融、気象など多様な分野の大規模な時系列データで事前学習し、トレンドや周期性、変動のパターンといった時系列に共通する特徴を獲得したモデルです。大規模言語モデル(LLM)が大量の文章で事前学習することで幅広いタスクに対応できるのと同様に、時系列基盤モデルは学習時に見ていない未知のデータに対しても、追加学習なしのゼロショットで予測できます。そのため、用途ごとにモデルを一から作る負担を減らせます。Google、Amazon、IBM、Salesforceなどの米国企業に加え、中国のAlibaba、韓国のLGなども相次いでモデルを発表しており、世界中で研究開発が進んでいます。
業務への導入では、予測精度に加え、実際のデータをどう入力し、結果をどう使うかが重要です。観測間隔のばらつきや欠測への対応、業務システムとの接続、予測の根拠の確認までを含めて、現場で使い続けられる形にする必要があります。
■ 時系列データ活用の3つの課題と、yoftの解決策
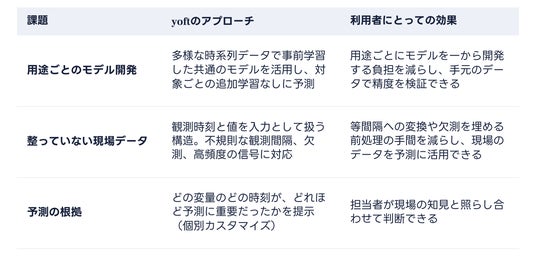
売上や気温、設備のセンサー値など、時間に沿って記録された数値を「時系列データ」と呼びます。yoftは、こうしたデータの活用で生じる次の3つの課題に取り組みます。課題1:用途ごとのモデル開発に手間がかかる
対象のデータだけでモデルを学習する方法では、商品や設備が増えるたびに設計と調整が必要になります。過去の記録が少ない対象では、十分な学習データを集めることも課題です。
課題2:現場のデータは「整っていない」
現場では、センサーごとに測定のタイミングがそろいません。通信断や点検で記録に欠損が生じ、さまざまな変量が異なる間隔で集まります。等間隔で欠損のないデータを前提とするモデルを使う場合、予測の前に間隔をそろえ、欠損を埋める前処理が必要です。その過程で、元の観測時刻や細かな変化を扱いにくくなることがあります。
課題3:予測の根拠が分からず、業務で使いにくい
需給計画や設備の保全では、予測結果だけでなく、判断の根拠も求められます。しかし、モデルの内部がブラックボックスになっていると、どの変量のどの時刻のデータが予測に影響したのかを確かめにくく、現場の知見と照らし合わせた検証や、予測に基づく判断の説明が難しくなります。
yoftの解決策
■ GIFT-Evalで、追加学習なしの手法として1位※2
GIFT-Evalは、Google、Amazon、IBMなどが性能評価に採用する、世界的に主要な時系列予測ベンチマークの一つです。Salesforce AI Researchが公開し、エネルギー、交通、経済・金融、医療、自然、売上、Web・クラウド運用の7分野を対象としています。秒単位から年単位まで10種類の観測頻度と、短期から長期の予測期間を組み合わせた97の評価設定で性能を比較します。当社のオーケストレーションモデル「yoft-o」(掲載名:TIMEHEDGE)は、GIFT-Evalの正規化MASEによる比較で、評価対象データで追加学習しない手法の中で1位を記録しました。追加学習の有無を問わない全143エントリーでも3位に入り、大規模言語モデル(LLM)を使わずにこの成績を達成しています(2026年10月14日確認)※2。
基準手法(直前の周期と同じ値が続くと仮定する予測)に比べ、97の評価設定をまとめた指標で、予測誤差を約35%低く抑えました。
指標:正規化MASE(小さいほど高精度)
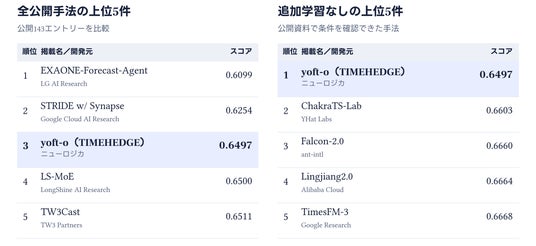
※2 順位・スコアは2026年10月14日確認の公開結果に基づく正規化MASE(各設定のMASEをSeasonal Naiveで割り、97設定で幾何平均した値)。「追加学習なし」はGIFT-Evalの学習・検証用データで、基盤モデルの追加学習や選択器・統合器の学習を行わないこと(構成要素を含む)。右表は公開資料で追加学習なしを確認できた手法の比較です。公式の部門区分ではありません。
出典:GIFT-Eval公式リーダーボード GIFT-Eval論文
■ 想定する活用例
エネルギー、製造、小売・物流など、幅広い分野での活用を想定しています。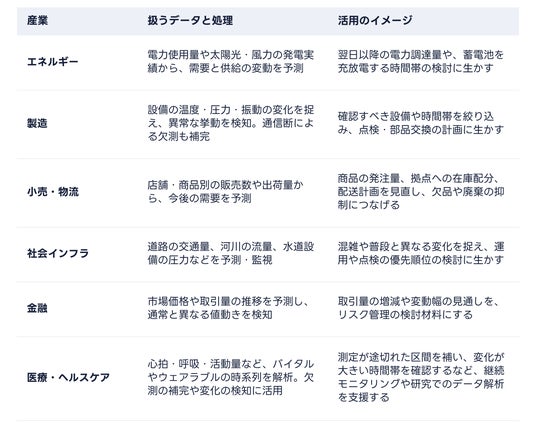
■ サービスの提供と導入のご相談
サービスサイト「yoft.ai」で、予測・異常検知・欠損補完のAPIを一般提供しています。手元のデータをブラウザ上で試すこともできます。推論は当社のサーバーで行うため、利用者側でGPUやモデルの運用環境を用意する必要はありません。現場のデータを使った検証やシステムへの導入に加え、予測に重要だった変量・時刻を示す説明可能性の機能、利用企業のサーバーやエッジ機器での運用についても、個別にご相談を受け付けています。
https://yoft.ai/ja#contact / [email protected]
サービスサイト:https://yoft.ai/ja
APIドキュメント:https://yoft.ai/ja/docs
■ 今後の展望:予測を、社会の意思決定インフラに
文章を扱う大規模言語モデルは、「読む・書く」仕事のあり方を一変させました。時系列基盤モデルは、「先を読んで決める」仕事を変える技術です。専門的なモデル開発に取り組まなくても、APIを通じて予測を日常業務に組み込めるようになれば、その活用は業種や企業規模を越えて広がります。当社は、予測が電力や通信と同じように、社会を支える当たり前のインフラになる未来を目指します。当社は今後も、モデルの精度と対応できるデータの幅を広げながら、各業界のパートナーと導入を進めていきます。
■ CEATEC 2026に出展
CEATEC 2026の当社ブースでは、yoftによる予測・異常検知・欠損補完のデモをご覧いただけます。現場のデータを使った検証や、業務システムへの導入についてもご相談いただけます。展示会:CEATEC 2026
会場:幕張メッセ
ブース番号:4H425(ホール4)
開催期間:2026年10月13日(火)~16日(金)10:00~17:00
■ 会社概要
会社名:株式会社ニューロジカ所在地:東京都渋谷区渋谷2丁目19-17 グローリア渋谷ビル7階
代表者:代表取締役 ピーク エイダン ゼファー
設立:2024年9月
事業内容:時系列予測基盤モデルの開発、AIモデル研究開発、技術パートナー
URL:https://neurogica.com
【本件に関するお問い合わせ】
株式会社ニューロジカ
広報担当:松本紗奈
Email:[email protected]
企業プレスリリース詳細へ
PRTIMESトップへ