背景:辞令から赴任まで2~3か月。ほぼ全員が、ゼロからのスタート
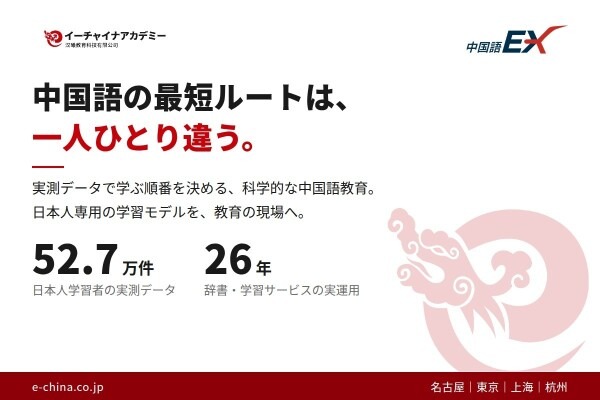
中国赴任者・日中ビジネス実務者の多くは、辞令から赴任までの2~3か月で、生活・同僚との関係づくり・業務のすべてを中国語で始めることになります。数千語の貯金がある英語と違い、中国語は貯金ゼロ。限られた準備期間で「これから必要な知識」を、どの順に学ぶかがすべてを決めます。
しかし従来の教材の多くは、現場の先生の経験によって作られてきました。経験は貴重な資産である一方、個人の暗黙知にとどまり、検証も再現も拡張もできません。市場規模が英語の40~130分の1(検定受験者 年間約5万人 対 216万~670万人)である中国語では、科学的に設計された教材が「作られない構造」が続いてきました。日本人がどこでつまずき、何を先に必要とするのかを実測し、そこから学習順まで設計した教材は、当社の調査範囲では確認できていません。
「日本人専用の学習モデル」とは:経験ではなく、実測で決める
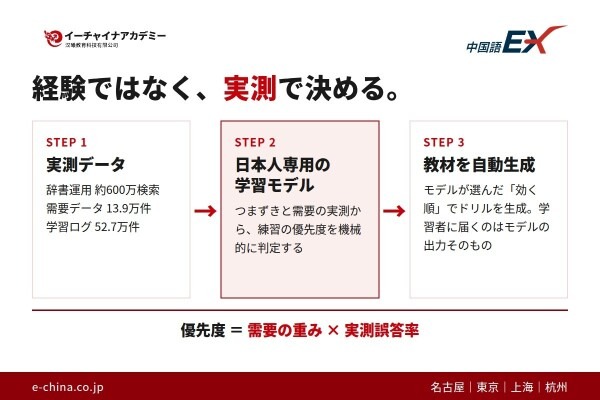
中国語EXの核心は、実測 → モデル → 教材生成の一連を当社独自に接続したことです。
● 実測データ: 辞書運用 約600万検索、需要データ(単語帳保存) 13.9万件、学習ログ 52.7万件。26年の実運用で蓄積した日本人学習者の実データ
● モデル構築: つまずきと需要の実測から、練習の優先度を「需要の重み × 実測誤答率」で機械的に判定する。第一号が「EX発音モデル」
● 教材生成: モデルが選んだ「効く順」でドリルを自動生成。学習者に届くのは、モデルの出力そのもの
「よく使う」×「よく間違える」--両方を満たすものから練習する。つまずくからといって練習するのではなく、限られた時間を効く順に配分する仕組みです。誤答率が高くても頻度が低いもの、頻出でも易しいものは、モデルが機械的に優先度を下げます。
教育現場での活用:発音レベルが受講生に稼働中
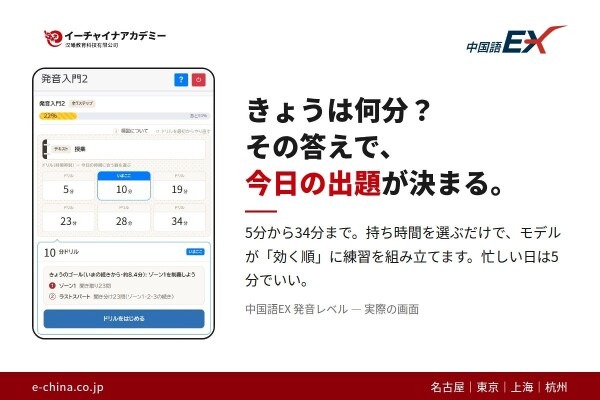
現在、当社の受講生に提供している発音レベルでは、学習者はその日の持ち時間(5~34分)を選ぶだけで、モデルが「今日の出題」を組み立てます。回答後は正誤に加えて「どの音と混同したか」を返し、音ごとの状態を「触れた → 気づけた → 馴染んだ」の段階で更新して、忘れかける時期に再出題します。1回は20分が上限、忙しい日は5分でよい設計で、週5日×5分から成立する継続を想定しています。
教育現場での活用:発音レベルが受講生に稼働中
現在、当社の受講生に提供している発音レベルでは、学習者はその日の持ち時間(5~34分)を選ぶだけで、モデルが「今日の出題」を組み立てます。回答後は正誤に加えて「どの音と混同したか」を返し、音ごとの状態を「触れた → 気づけた → 馴染んだ」の段階で更新して、忘れかける時期に再出題します。1回は20分が上限、忙しい日は5分でよい設計で、週5日×5分から成立する継続を想定しています。
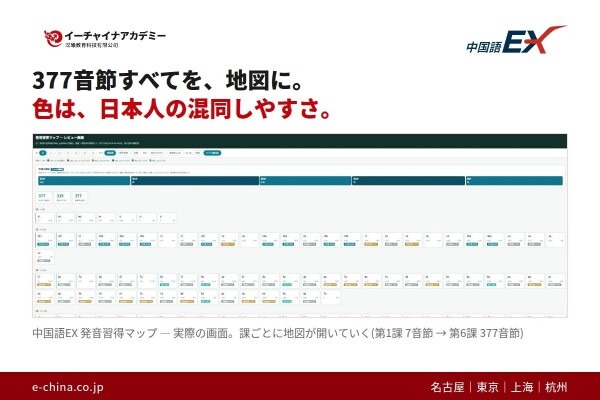
モデルが示したこと:2音節8,583語の声調結合を20マスに。優先すべきは、たった4マス
HSK3.0の2音節語8,583語の声調の組み合わせは20マスに収まります。語彙シェア×実測誤答率で優先スコアを出すと、最優先の「4声+4声」は語彙シェア14.1%、誤答率47%で、この1マスだけで学習対象語彙に生じる誤りの23%を占めます。上位4マスで加重誤りの50%が集中し、均等配分(20%)の2.5倍でした。
※ 上記は観測データ上の集中度を比較したモデル試算であり、学習時間短縮や学習効果の実測値ではありません。
EXは、先生を置き換えない
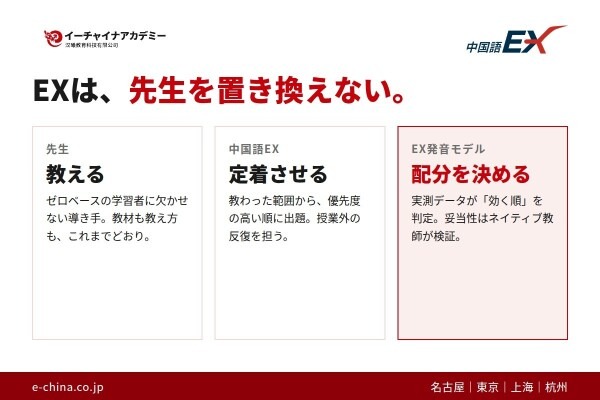
教えるのは先生。定着させるのがEX(教わった範囲から優先度の高い順に出題)。配分を決めるのがEX発音モデル(実測データが「効く順」を判定)。モデルの妥当性はネイティブ教師が検証し、裁定(声調変化の扱いなど)を設計に反映しています。一度きりの監修ではなく、モデル更新のたびに続く検証ゲートです。AIは「会話の相手」ではなく、「教材を作る研究の協働者」
52.7万件の学習ログを設問型ごとに切り分けた統計解析、混同モデルに基づく誤答選択肢の自動生成(全394音節×9次元の音韻距離モデル)、AIとの協働開発により、従来はチーム開発でしか実現できなかった規模の教材研究を少人数で成立させました。市場が小さくても、科学的教材は作れる--この方法論自体が、当社の提案です。
個人化について
現在稼働している発音レベルは、日本人全体の実測(集団の基準値)に、先生の進度・その日の持ち時間・本人の進捗を掛けて出題を組み替える「第1段」です。本人の解答履歴で補正する「第2段」は方式の検証とネイティブ教師の確認を終えており、EX本番のログが溜まり次第、接続します。切り替えではなく、全体の地図から本人の地図へ連続的に移行する設計です。
今後
発音(提供中) → 単語(実測データでモデル検証を完了、ドリル実装に着手) → 語学ポイント(文法・語用、同型のモデル構築を計画)の順に、モデルを重ねて地図を広げていきます。基盤ログは既存サービスの実運用データ(累計学習者約4,000人=2017年~/解答ログ52.7万件=2025年11月~2026年5月・学習者250人の実測)であり、『中国語EX』としての本格運用はこれからです。受賞歴
第14回 日本e-Learning大賞 語学教育特別部門賞(2017年11月、主催: 一般社団法人e-Learning Initiative Japan)― クラウド型中国語学習サービス「スマチュ」https://e-china.co.jp/pressrelease/20171103/
配信元企業:株式会社イーチャイナ
プレスリリース詳細へ
ドリームニューストップへ